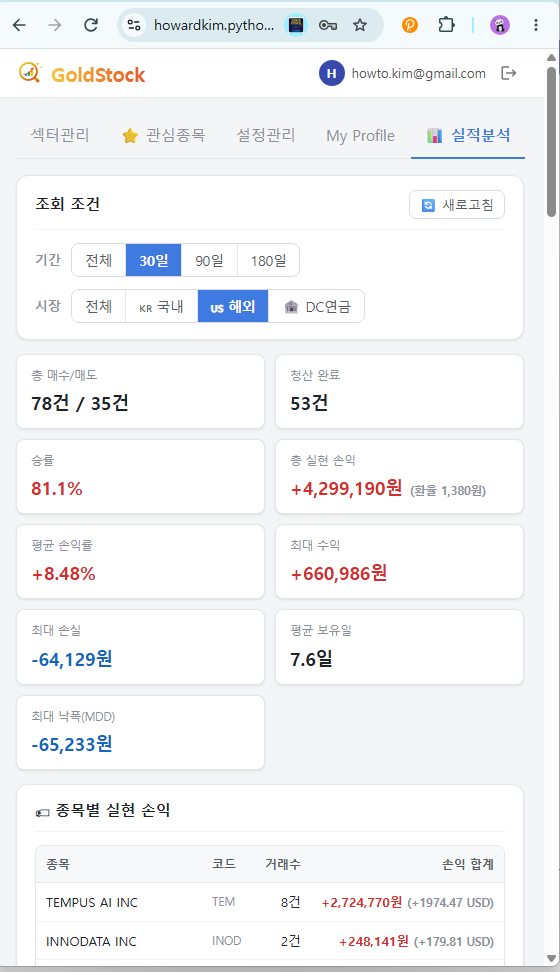
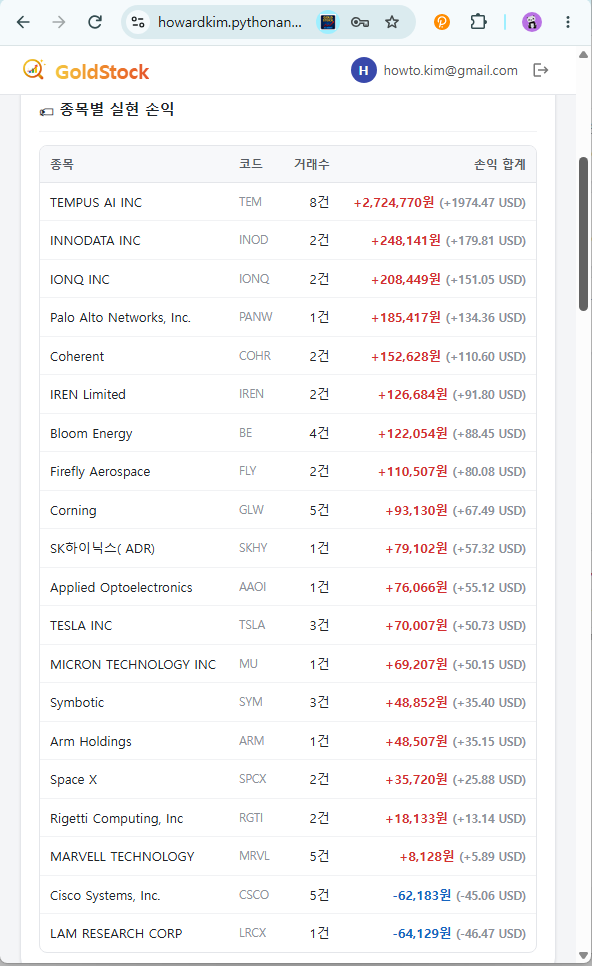
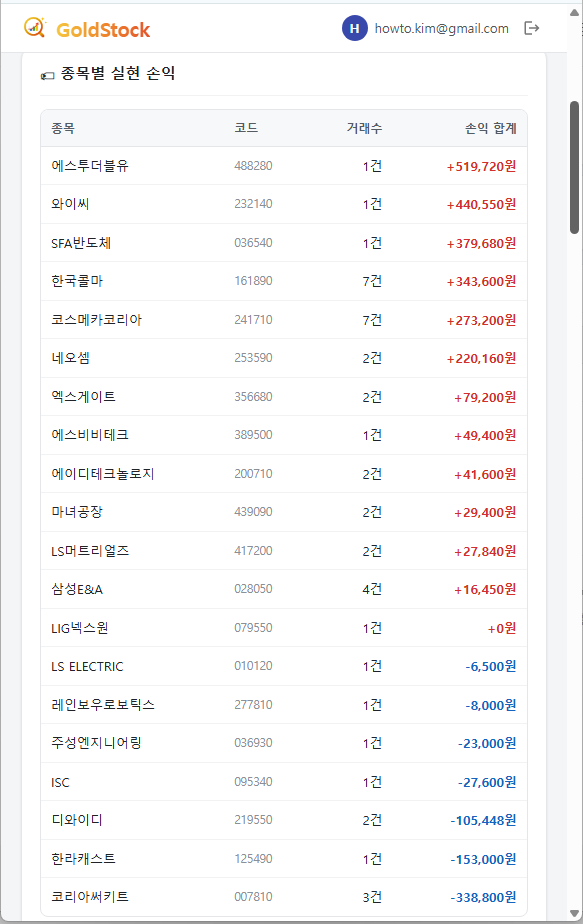
주식 뉴스를 매일 챙겨 보는 건 생각보다 고된 일이다. 어제 무슨 일이 있었는지, 지금 어느 업종으로 돈이 흘러 들어가는지, 내가 보는 종목의 차트가 지금 살 자리인지 — 이걸 매일 손으로 확인하다 보면 정작 판단할 시간이 없다.
그래서 GoldStock을 만들었다. 한국과 미국 시장을 매시간 스스로 읽고, 섹터 단위로 정리해서 보여주고, 추천 종목은 차트로 한 번 더 검증하는 개인 프로젝트다. 이 글은 그 구조에 대한 기록이다.
👉 https://howardkim.pythonanywhere.com/
- 한 줄로 말하면
뉴스와 시장 지표를 모아 섹터별로 요약하고, 자금이 들어오기 시작한 섹터를 먼저 보여주며, 종목 추천은 차트·백테스트로 검증하는 에이전트.
[여기에 goldstock-02-intro.jpg 를 넣으세요]
- 왜 '종목'이 아니라 '섹터'인가
처음에는 종목 단위로만 봤다. 그런데 개별 종목 뉴스는 노이즈가 심하다. 한 회사의 호재 하나로 주가가 튀는 건 흔한 일이고, 그게 추세인지 하루짜리인지 구분이 안 된다.
반면 섹터 단위 심리는 훨씬 천천히, 그리고 함께 움직인다. 반도체 소부장 전체의 뉴스 톤이 2주째 가라앉아 있다가 갑자기 올라오기 시작하면, 그건 개별 회사 이야기가 아니라 자금 흐름이 바뀌는 신호일 가능성이 높다.
그래서 이 앱의 핵심 화면은 종목 리스트가 아니라 섹터 요약이다. 각 섹터의 심리 점수 추이를 보고 "정체·하락 → 상승 전환" 구간을 잡아 요약 첫 줄에 표시하고, 해당 섹터를 목록 맨 위로 올린다. 자금 유입 초기일 가능성이 있는 구간을 놓치지 않기 위해서다.
- 파이프라인
매시간 도는 배치가 하는 일은 대략 이렇다.
1) 뉴스 수집과 요약
NewsAPI로 한국·미국 시장 뉴스를 모으고 LLM으로 섹터별 요약을 만든다. 처음에는 OpenAI API를 썼는데 크레딧이 떨어지면서 요약이 전부 실패한 적이 있다. 지금은 Gemini 우선 + OpenAI 폴백 라우터를 따로 두고 있다. 한쪽이 죽어도 파이프라인이 멈추지 않는 구조가 필요했다.
2) 시장 지표 수집
S&P 500, 나스닥, VIX, 유가, 국채 금리, 환율 같은 지표를 붙인다. 이 부분이 의외로 손이 많이 갔다. yfinance가 429(Too Many Requests)로 자주 막히고, 대체로 쓰던 Stooq는 어느 날 모든 심볼에 HTML을 돌려주며 사실상 죽었다. 지금은 FRED → Naver → Stooq 순으로 폴백하고, 끊긴 FRED 시리스는 후보 목록을 순서대로 시도한다.
외부 데이터 소스는 언젠가 반드시 죽는다. 한 곳만 믿으면 안 된다는 걸 이 프로젝트에서 제일 확실하게 배웠다.
[여기에 goldstock-03-summary.jpg 를 넣으세요]
3) 강화학습 모델
종목과 섹터마다 PPO(Proximal Policy Optimization) 모델을 학습시켜 두고, 매시간 배치가 그 판단을 가져온다. 섹터 모델은 해당 섹터 소속 종목 데이터를 하나씩 학습하는 방식이라, 섹터 체계를 한 번 갈아엎었을 때 전체 재학습에 73분이 걸렸다.
4) 차트 검증
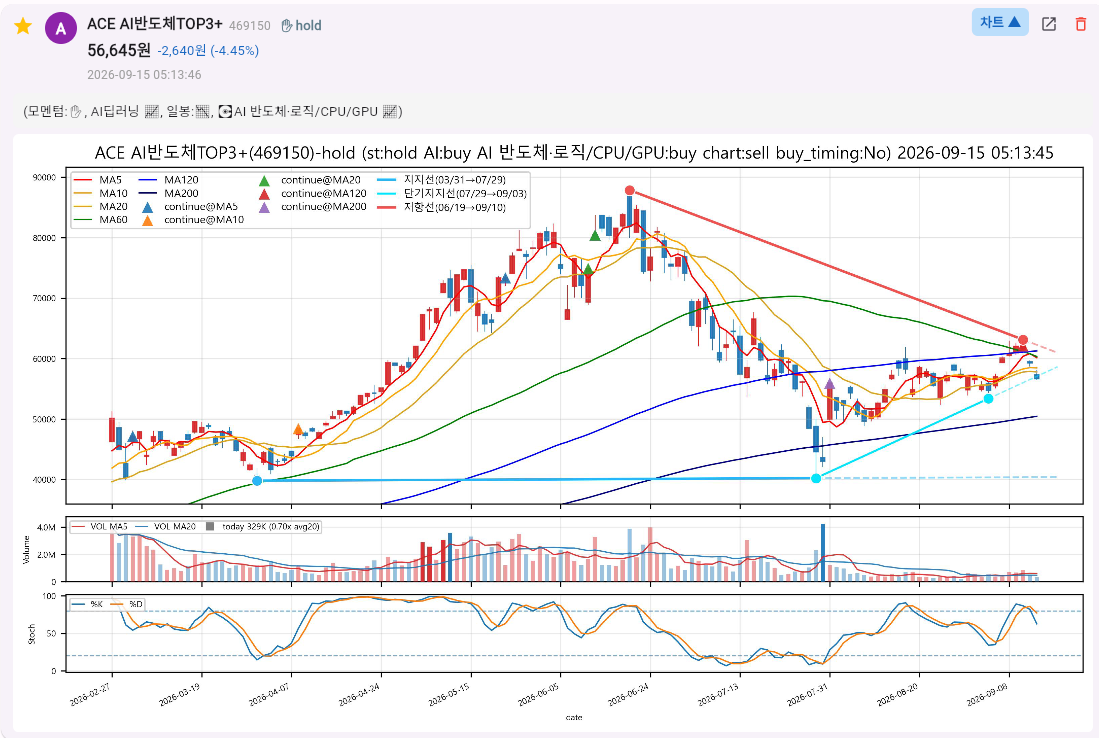
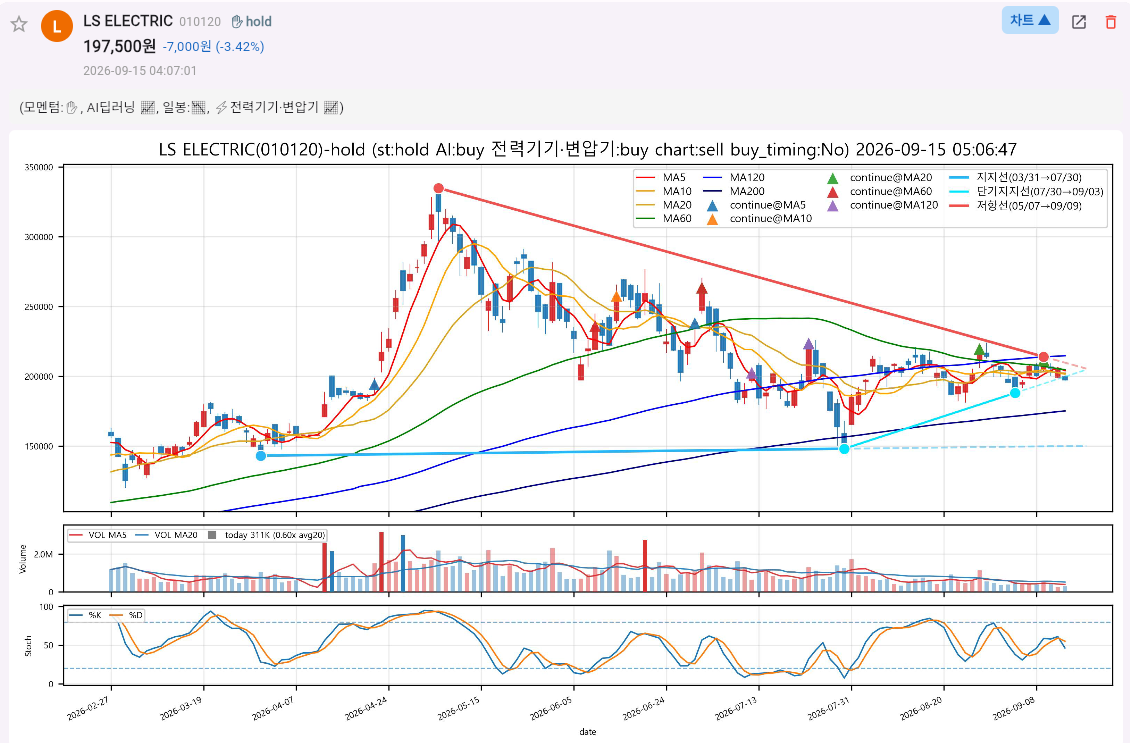
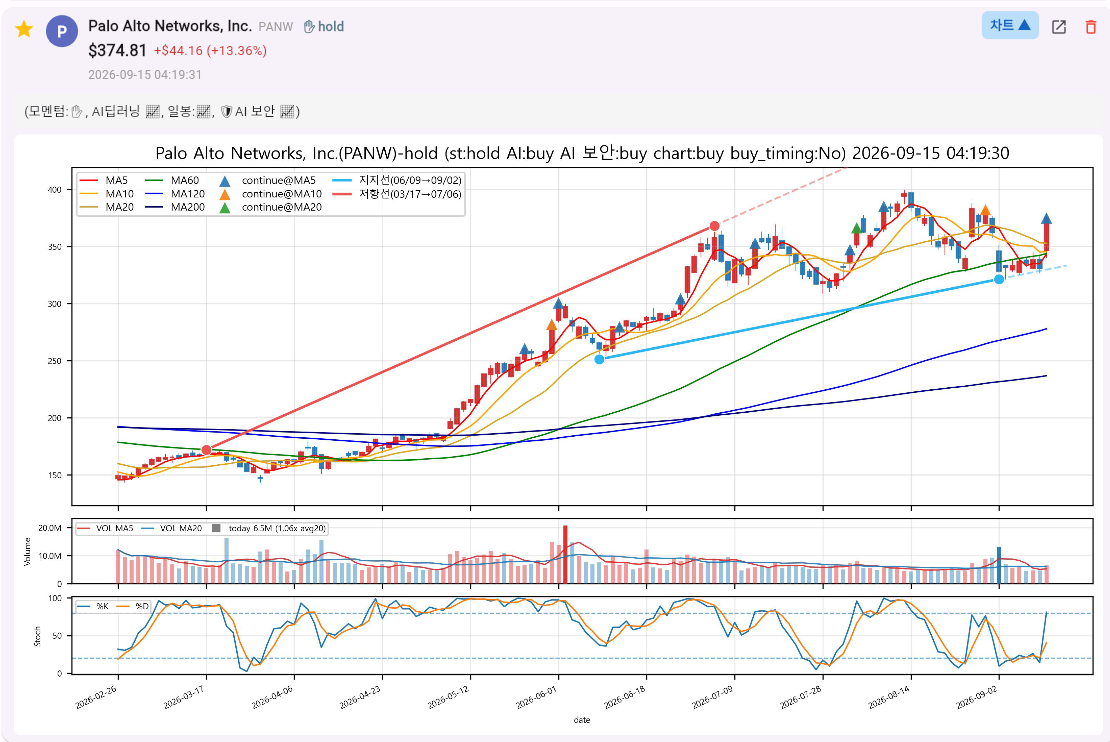
모델이 좋다고 해도 그대로 믿지 않는다. 이동평균 크로스오버 백테스트, 스토캐스틱, 거래량을 3단 패널 차트로 그려서 매수 타이밍을 한 번 더 본다. 거래량은 상승·하락 색을 구분하고 MA5/MA20을 겹쳐, 20일 평균의 2배 이상 급증한 봉을 강조한다.
5) 지지선 붕괴 감시
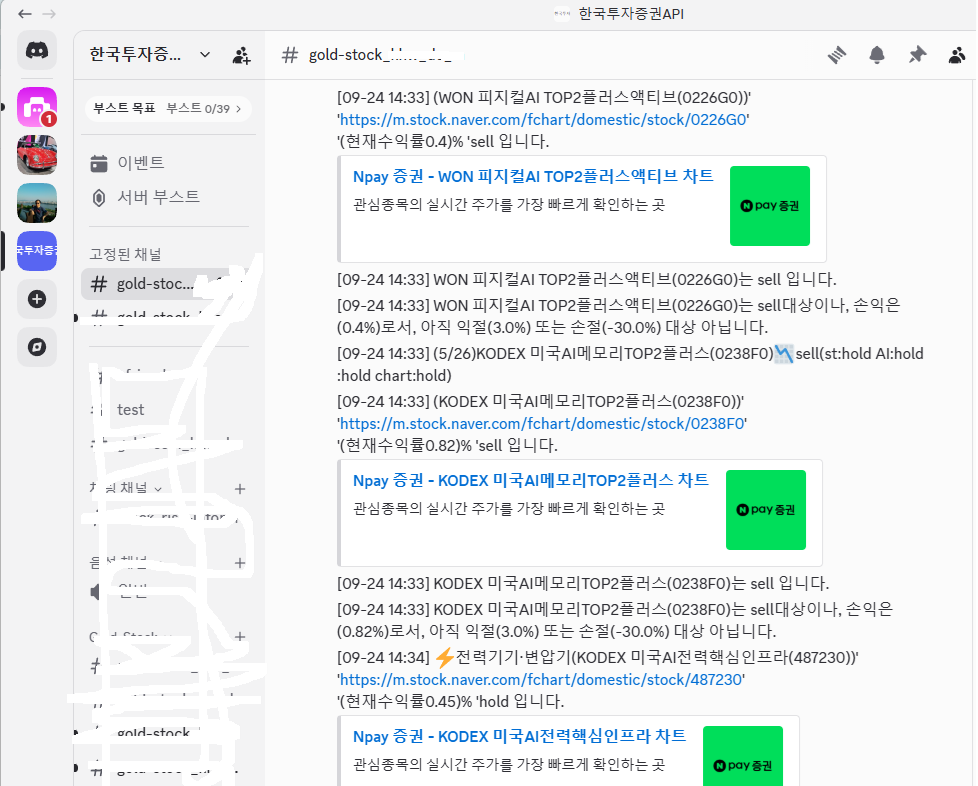
보유 종목이 지지선을 깨면 그날 바로 던지는 게 아니라, 익일 이후 '붕괴일 저가 이탈 + 음봉'이 확인될 때 전량 매도한다. 5거래일 동안 감시하고, 그 사이 종가가 지지선 위로 회복하면 감시를 해제한다. 하루짜리 노이즈로 보유 종목을 털어내지 않기 위한 장치다.
- 섹터 체계를 갈아엎은 이야기
이 프로젝트에서 가장 크게 고친 부분이다. 처음에는 섹터가 59개였는데, 문제가 있었다.
NVDA가 4개 섹터에, AMD가 5개 섹터에 동시에 속해 있었다. 심리 점수는 소속 종목의 뉴스로 산정되니, NVDA 뉴스 하나가 4개 섹터의 점수를 동시에 올린다. 서로 다른 4개 섹터에서 "자금 유입 전환"이 뜨고, 화면 상단이 같은 이야기로 도배된다. 신호가 네 배로 부풀려진 것이다.
그래서 59개를 23개로 통합하고 '대표 섹터 1개 + 보조 태그' 구조로 바꿨다. 점수 산정은 대표 섹터에서만 한다. 중복 소속으로 부풀려지던 신호가 사라졌고, 학습 패스도 45% 줄었다.
이 작업에서 크게 한 번 넘어지기도 했다. "ETF는 섹터가 아니라 속성이니 매핑에서 빼자"고 판단해 ETF 51종목을 뺐는데, 그 매핑 테이블이 점수 산정 단위이면서 동시에 추천·차트 생성 대상 목록이라는 걸 놓쳤다. 점수만 안 나온 게 아니라 종목이 서비스에서 통째로 사라뜡다. 국내 배치 대상이 163개에서 113개로 줄었는데 로그에는 경고 한 줄 남지 않았다.
교훈은 단순하다. 어떤 테이블에서 행을 지우기 전에, 그 테이블을 읽는 쪽을 전부 확인한다. "빼도 된다"는 판단에는 반드시 건수 확인을 붙인다.
- 프론트엔드는 Flutter
웹과 안드로이드를 한 코드로 만들려고 Flutter를 골랐다. 웹은 PythonAnywhere에 배포하고, 폰에서는 직접 빌드한 APK로 쓴다.
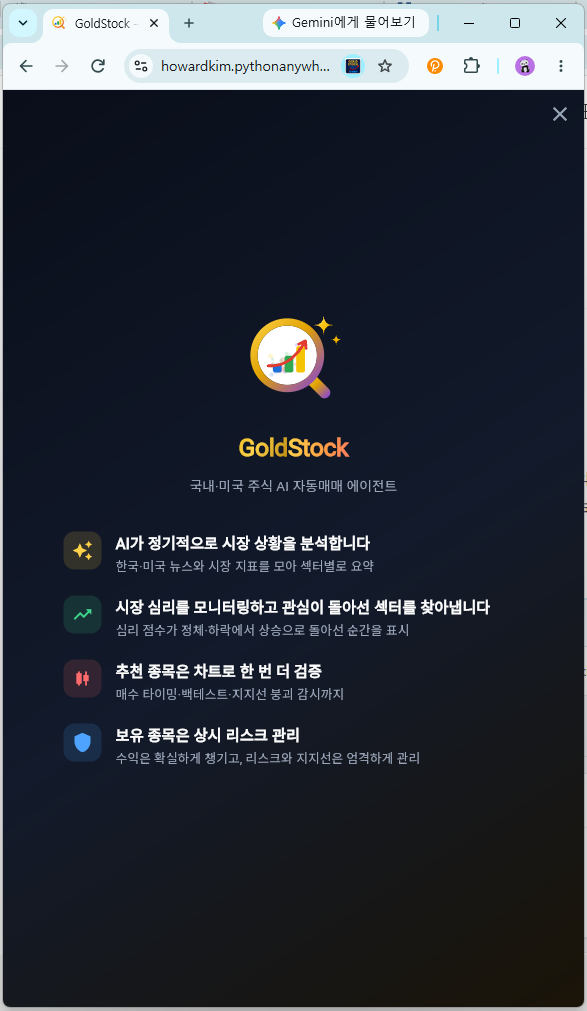
최근에는 첫 화면을 손봤다. 앱을 열면 로고 스플래시가 뜨고, 최초 설치 시에만 한 장짜리 소개 화면이 이어진 뒤 요약 화면이 나온다.
[여기에 goldstock-01-splash.jpg 를 넣으세요]
만들면서 재미있었던 지점이 두 개 있다.
하나는 스플래시를 순차로 만들면 안 된다는 것. 요약 화면은 뜨자마자 미국·국내 요약 JSON 두 건을 네트워크로 받는데, 스플래시를 먼저 띄우고 끝나면 요약 화면을 만드는 구조로 짜면 스플래시가 로딩을 가리는 게 아니라 로딩 앞에 시간을 더하는 꼴이 된다. 그래서 요약 화면 위에 스플래시를 겹쳐 두는 방식으로 만들었다. 네트워크 요청이 t=0에 시작되고, 스플래시가 그 대기 시간을 대신 덮는다.
다른 하나는 Flutter 웹에서는 스플래시조차 늦게 뜬다는 것. Flutter 스플래시는 엔진이 올라온 뒤에야 그려지는데, 그 전까지 JS 번들과 렌더링 엔진을 받는 동안이 통째로 백지다. 재방문에도 약 2초, 첫 방문은 더 길다. 스플래시를 넣어 놓고도 정작 첫 화면은 흰 화면이던 셈이다.
그래서 index.html에 순수 HTML/CSS 부트 화면을 넣고, 배경·로고·문구를 Flutter 스플래시와 같은 값으로 맞췄다. 엔진이 올라오면 같은 그림 위에서 페이드아웃하므로 전환이 눈에 보이지 않는다. 사용자에게는 처음부터 끝까지 하나의 화면으로 느껴진다.
- 마치며
아직 다듬을 곳이 많다. 섹터 모멘텀을 실제 매매 점수에 반영하는 작업은 관찰 기간을 두고 보수적으로 진행 중이고, 모멘텀 단독으로는 매수 도 매도도 발생하지 않도록 막아두었다. 자동매매에서 제일 무서운 건 잘못된 신호가 아니라 검증 없이 신호를 믿는 구조라고 생각한다.
화면은 아래에서 직접 볼 수 있다.
👉 https://howardkim.pythonanywhere.com/
※ 이 프로젝트는 개인적으로 만들어 운영하는 것이라, 특정 종목의 매수·매도를 권유하지 않습니다. 화면에 표시되는 요약과 추천은 참고 자료일 뿐이고, 투자 판단과 그 결과에 대한 책임은 투자자 본인에게 있습니다.